产线上的AI不是数据越多越好,先验收数据是否对路
美国国家标准与技术研究院指出,工业AI的价值取决于数据是否相关、完整、有代表性,而不是堆得越多越好;同时缺乏标准评估工具会放大误用与不信任。用一条产线的数据验收试验,先问清楚训练和运行数据是否对路,再决定是否信任预测。
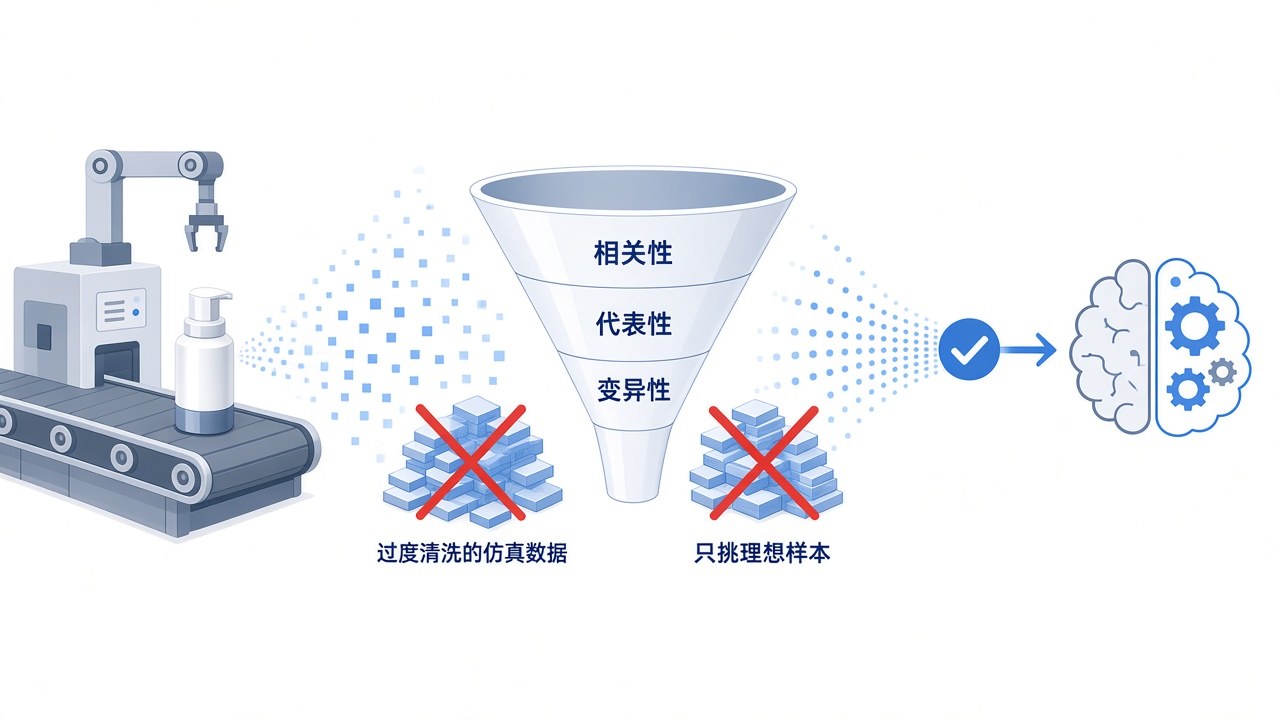
一家做精密零部件的工厂刚上线了缺陷预测模型。供应商演示时准确率很高,质量总监却在试运行第二周发现:模型对夜班、换型后的批次几乎“失灵”。翻训练说明才发现,演示用的是白班、稳态工况下挑过的样本,故障停机、换刀后的数据要么被“清洗掉”,要么根本没进训练集。
这是假设场景,但它对应一个正在被写进工业AI讨论的问题:在信任预测之前,工厂该如何验收训练数据和运行数据是否对路。
已经发生的事
【事实】美国国家标准与技术研究院(NIST)制造业创新博客2025年2月4日刊发Michael Sharp的文章《How to Find the Right Balance of Data for Your Industrial AI System》。文中把工业AI输入数据描述为经典的“垃圾进、垃圾出”问题:训练数据须相关、准确,并与待解任务有可理解的关联;若数据与真实工况不匹配,系统就会误导决策。文章点名三类危险信号:过度简化的仿真、只挑理想情形的样例、过度清洗或平滑以致看不见车间真实变异。
【事实】同一篇文章提出两个验收式问题:一是工业AI是否接到了所有相关信息源(不同设备、班次甚至部门);二是数据是否覆盖用例的完整范围,包括稀有事件(例如设备故障)。作者明确写:数据更多并不自动等于更好;无关数据会搅浑判断,关键是质量与相关性。常见陷阱包括:数据不完整、代表性样例过少、变异不足、状态之间存在大段缺口。
【事实】NIST的工业人工智能管理与计量(IAIMM)项目页说明:工业AI的表现离开其对系统与使用者的影响就没有意义;项目自2022年10月启动,页面状态为已完成(Completed),目标是发展测量科学,以促进基于信任的采纳、用风险意识指标传达价值,并形成部署与评估最佳实践。页面指出,教育门槛加上缺乏标准评估工具与管理方法,导致制造企业对工业AI犹豫、不信任与误用;多阶段制造是重点用例,涉及设备、设计、执行、零件质量、系统交互、人工反馈、过程绩效等多样数据类型。
这些是NIST公开页写明的内容。它们不是某一家工厂的实测成绩,也不等于中国制造企业已有强制数据验收标准。
变化的机制:先验收“对路”,再谈“够不够多”
过去采购工业AI,谈判常停在算法品牌、算力和演示准确率。演示集往往是稳态、干净、可复现的理想切片;真实产线却是多班次、换型、缺料、人为干预并存的环境。于是“演示漂亮、上线失灵”并不神秘——训练分布与运行分布脱节。
NIST博客把验收重心前移到数据:相关源有没有接上、稀有事件有没有进样本、清洗有没有把真实噪声抹平。IAIMM则把评估锚定在系统级影响:准确率数字离开产线结果、操作员决策和风险场景,本身难以解释投资是否值得。两者合在一起,形成一种采购语言:不是“给我更大的数据集”,而是“请证明这些数据代表我要用的场景,并说明缺口处如何人工监控”。
对经营的影响
【推演】第一,供应商筛选标准会变。能说清数据来源、班次覆盖、故障样例占比和清洗规则的方案,比只报“百万条样本”更有说服力。演示准确率仍重要,但若无法对照真实工况清单,采购方应下调信任权重。这一判断成立的前提是买方愿意做工况对照,而不是只比报价。
【推演】第二,内部数据治理会被迫前移。若关键字段散落在设备、质检、工单三套系统,模型再好也只能看见局部。企业可能先投入接口与主数据,而不是先换算法。受益的是已有追溯与多源采集的工厂;吃亏的可能是把“上AI”理解成一次性软件采购的团队。
【推演】第三,信任会从“黑箱准确率”转向“可问责的评估”。IAIMM强调缺乏标准评估工具会加剧误用。企业若能把风险场景、人工接管条件写进验收,管理层更容易决定哪些工位可以半自动、哪些只能辅助提示。这部分是推演,目前没有公开统计证明统一验收清单能降低多少误判损失。
建议试验:给一条产线做“数据对路验收”
以下是编辑提出的建议试验,不代表任何企业已经实施。
选一条已有或拟上预测模型的产线,固定一个明确用例(例如某外观缺陷预测)。用两周时间,不改模型,只做数据盘点。
投入:一名工艺/质量工程师加一名数据或IT人员,约十个工作日;不采购新平台。
做法:列出模型训练与运行实际用到的字段来源;对照NIST式清单勾选——相关源是否接全、是否含换型/夜班/故障等稀有情形、清洗规则是否去掉了真实变异;另列“缺口清单”,写明缺口出现时由谁监控、如何降级为人工。
判断指标:一是覆盖率,预定关键工况中有多少在训练或近30天运行数据中至少出现过可核对样例;二是来源完整度,预测所依赖字段能追溯到原始系统的比例;三是清洗敏感度,对同一批原始数据按现行清洗规则处理后,关键变异指标(如缺陷率分布宽度)变化是否过大。
失败条件:若关键稀有工况完全缺失,或清洗后分布相对原始数据明显“变平”、且缺口处没有人工监控预案,则不应把现有准确率当作可上线依据。此时优先补采集与监控,而不是加更多同类稳态数据。
边界
数据对路不等于模型正确,更不等于工艺本身合格。过度追求“脏数据全保留”也可能引入标注错误;关键是清洗规则可解释、可复核。仿真数据并非一律不可用,但若仿真明显简化真实约束,应降权或仅作补充。NIST材料面向工业AI评估与管理讨论,不是对中国工厂的强制规范。
对制造企业而言,问题可以收成一句:在问“AI准不准”之前,先问“它看见的,是不是我这条线真实会碰到的情况”。
参考资料
- NIST Manufacturing Innovation Blog:Michael Sharp,How to Find the Right Balance of Data for Your Industrial AI System(2025-02-04),https://www.nist.gov/blogs/manufacturing-innovation-blog/how-find-right-balance-data-your-industrial-ai-system ,核验日期 2026-11-02
- NIST:Industrial Artificial Intelligence Management and Metrology (IAIMM) 项目页,https://www.nist.gov/programs-projects/industrial-artificial-intelligence-management-and-metrology-iaimm ,核验日期 2026-11-02
本文署名为赛博AI编辑整理;资料核验截至2026-11-02。假设场景、建议试验和推演不代表已经验证的结果。