实验室开始自我迭代,科研怎样加速
自主实验室把配方选择、实验执行与结果分析连接起来,让下一轮实验更快开始。真正需要衡量的,是每次循环增加了多少可靠知识。材料研究的公开成果及其更正提示我们:实验速度可以提高,证据标准、复核责任与开放条件仍须一起建设。
2020 年,一台移动机器人在实验室里连续工作八天,完成了 688 次光催化实验。它在仪器之间移动,依照搜索算法调整配方,寻找更好的制氢催化体系。这是利物浦大学研究团队发表于《自然》的实际研究。值得关注的细节,是前一轮测量能够进入下一轮选择,操作与判断之间的等待因而缩短。研究原文
已发生:实验开始形成反馈回路
传统实验也依靠反馈。研究人员查文献、提出假设、制备样品,再根据结果修改方案。自主实验室把其中一部分环节连接成可重复运行的流程:系统提出候选条件,设备执行实验,分析程序读取数据,搜索策略据此更新。这里的“自我迭代”有明确边界,通常指在给定目标、仪器能力与安全约束内调整实验,不能由此推断它已能独立决定所有研究方向。
2023 年发表的 A-Lab 研究,把文献信息、计算预测、机器学习、主动学习与机器人合成连接起来。依照截至 2026 年的更正版,系统在连续运行的 17 天内,从 57 个目标中实现了 36 种化合物的合成。这个结果展示了自动化循环的能力,也提供了观察其边界的窗口。更正后的论文
编辑分析:怎样确认“做出来了”
A-Lab 论文在 2026 年 1 月发布作者更正。作者重新分析衍射数据,排除了证据仍不明确的结果,并澄清原先的新颖性表述:对预测平台而言的新材料,未必是科学界从未知道的材料。这次修正提醒读者,仪器读数、算法分类与经过检验的科学结论之间,还有需要承担判断责任的距离。作者更正
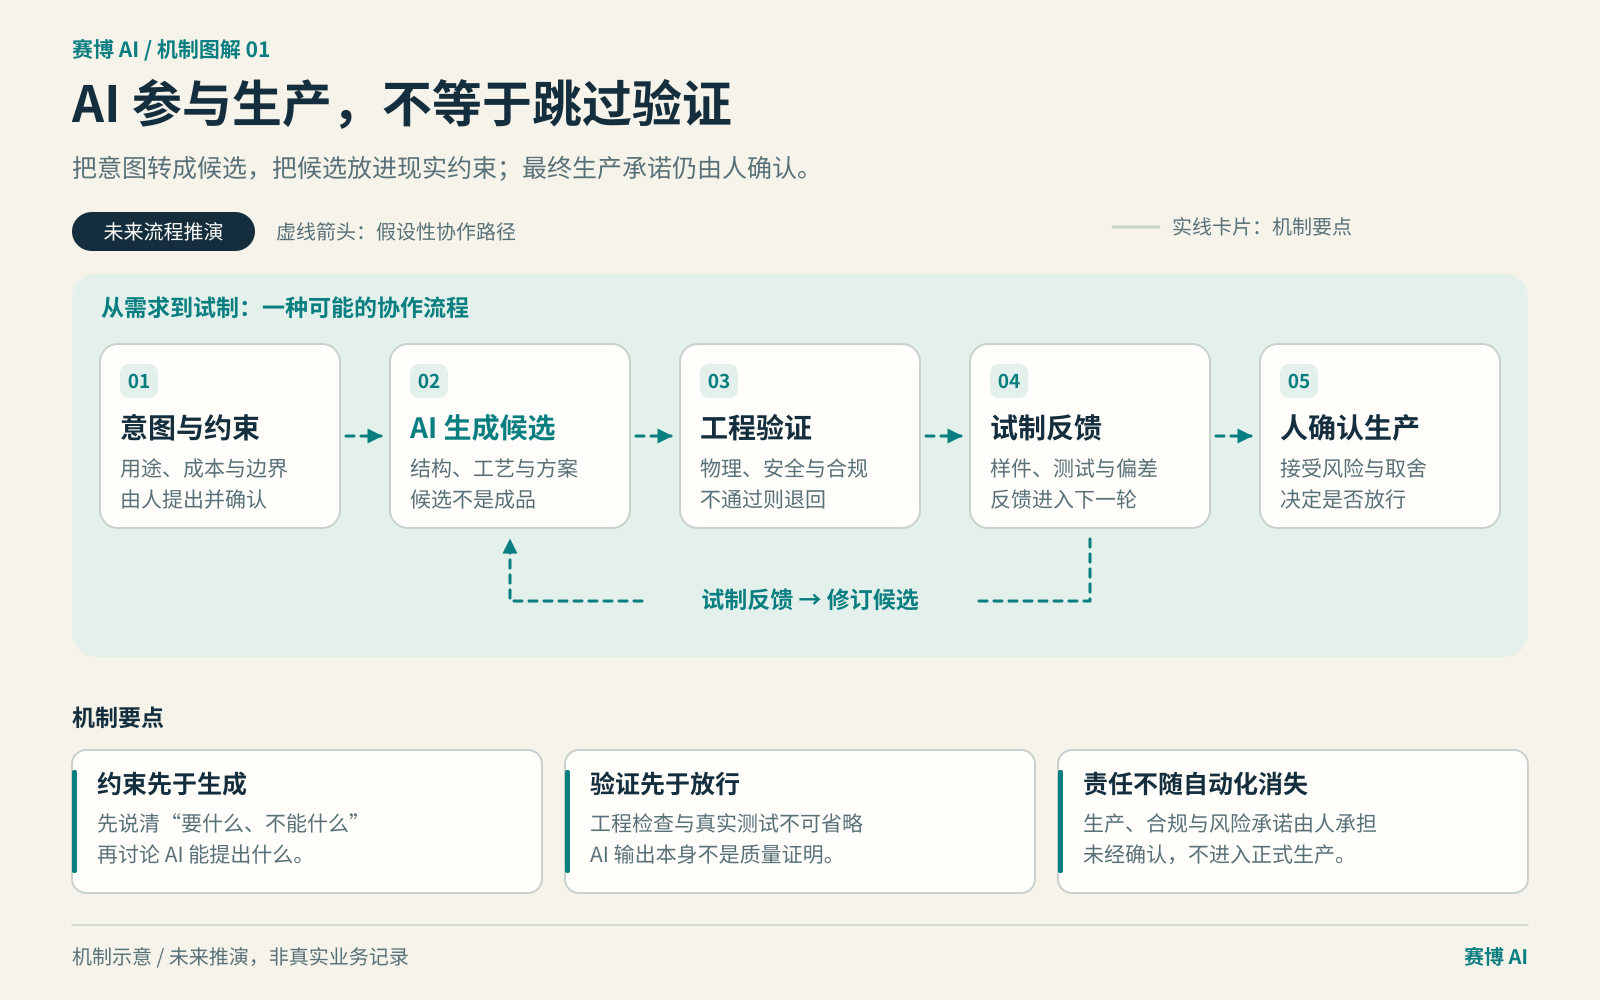
由此可以提出一种更严格的效率尺度:单位时间内增加了多少可复核的知识。实验次数适合衡量设备吞吐量,却不能单独衡量发现质量。若传感器持续偏移、样品存在污染,或者分类器把混合物误判为目标产物,更快的循环也可能积累更多同方向的错误。独立测量、空白对照与人工复核因此需要进入流程设计,而不能只在论文提交前临时补上。
选下一次实验同样包含取舍。沿着目前最好的配方继续优化,容易获得短期改进;探索不确定区域,则可能产生失败记录,也可能揭示原有假设遗漏的机制。目标函数如何设定、失败是否完整保留、设备异常是否与科学上的负结果分开记录,会共同影响系统究竟在学习什么。自动化越深入,这些研究设计越需要清楚。
未来推演:共享能力,也共享检验责任
如果远程实验服务逐渐成熟,一支没有完整仪器配置的团队,可能通过标准接口提交任务,获得原始数据与实验记录。这是值得验证的组织方向,尚不能视为所有研究者已经获得的能力。样品运输、设备排队、耗材成本、危险操作限制与数据权限,都可能成为新的门槛。接口开放并不会自动消除物理条件的差异。
受益者可能包括需要大量重复试验的研究团队,以及擅长提出问题、但缺少设备条件的小型机构。与此同时,负责维护、校准和异常处置的人,其工作可能被界面遮蔽。如果评价体系只奖励提交任务与发表结论,支撑数据可靠性的劳动就容易被低估。共享实验平台应当把这些责任和成本纳入成果记录。
还可以追问,谁有权改变搜索目标,谁可以暂停运行,谁来检查一组过于整齐的结果。把这些权限留痕,有助于分清研究假设、自动执行与最终解释各自的来源。对外开放的也应包括失败条件和更正记录,让后来者知道哪些路径已经走过,哪些结论仍不稳定。
实验室的加速最终要回到一个朴素问题:下一位研究者能否依照这些记录,理解并检验这里发生的事。机器可以缩短一轮实验的时间;科研共同体仍要决定,哪些结果值得进入下一轮知识积累。
资料核验截至 2026 年 10 月 28 日。文中“未来推演”为基于上述研究的编辑分析,不代表已经普遍实现。