让机器人训练数据接受现场验收
合成数据扩展机器人训练素材,也让数据覆盖、现场留出测试与换线复验成为生产管理问题。用研究和厂商技术流程建立证据边界,再以低风险工位检验真实收益。
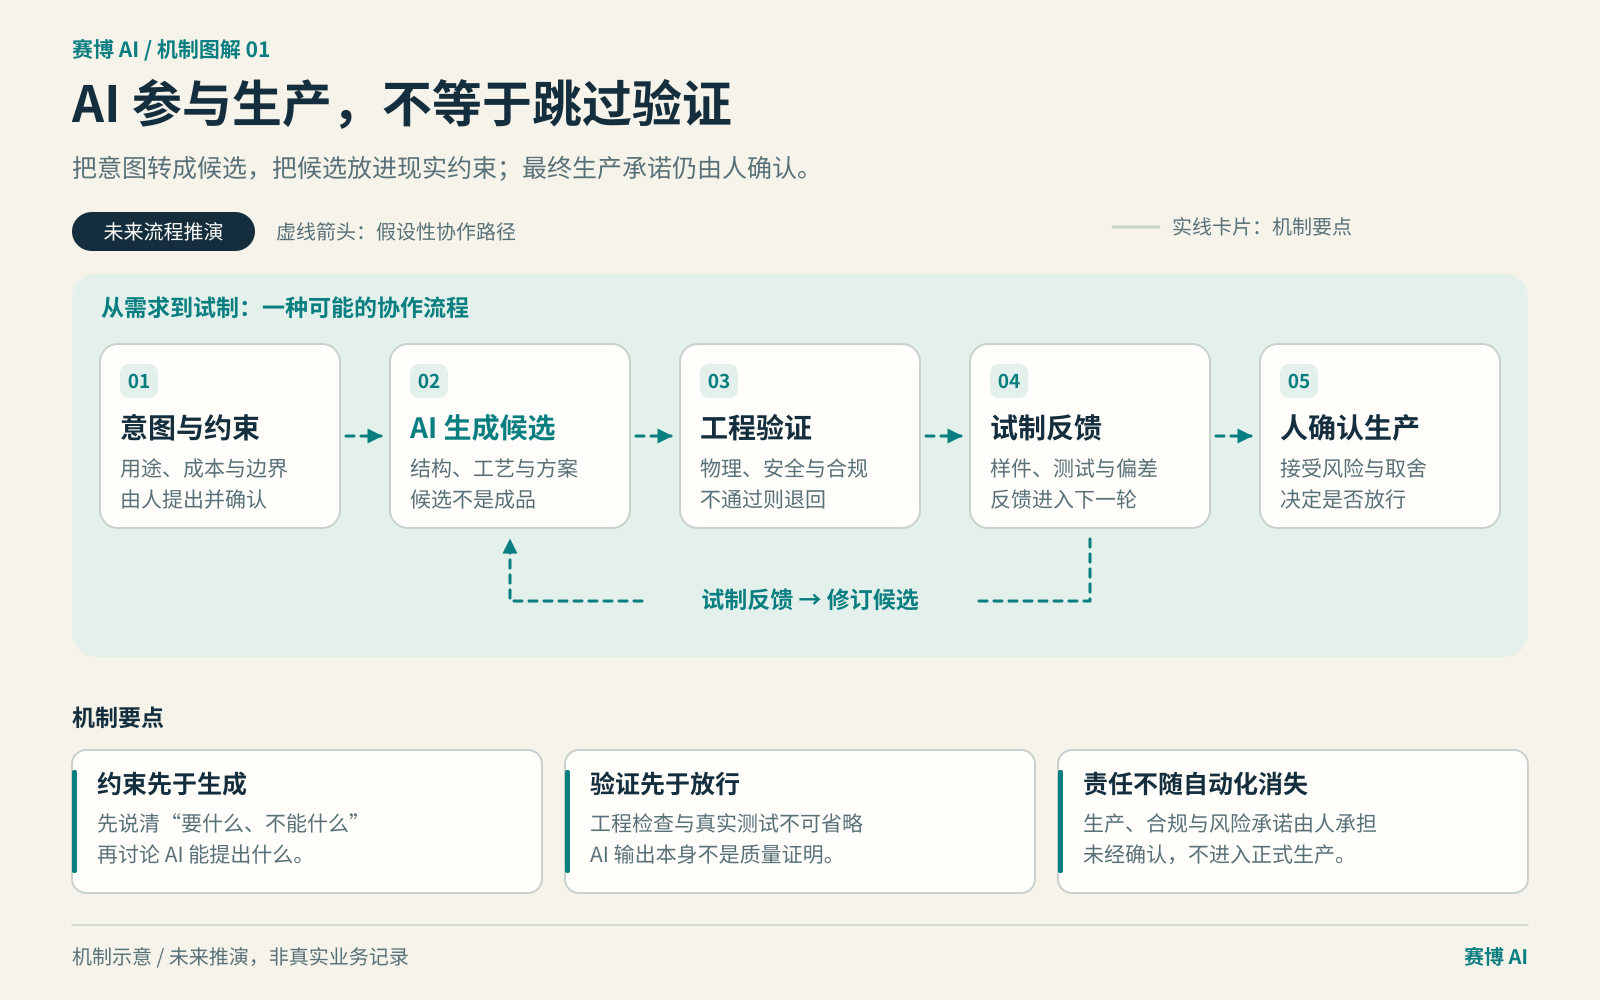
机器人项目有一道容易被演示视频遮住的成本:为了让机器学会换一种零件、适应另一种摆放位置,人还要补多少次示范?合成数据让部分重复练习进入虚拟环境,也把生产管理的新问题推到台前:企业怎样判断,生成的训练数据确实减少了现场试错,而不只是让数据集变大?
已经发生的变化
MimicGen研究团队在原始项目中报告,用不足两百个人类示范,生成了超过五万条示范数据,覆盖十八项任务、多个仿真器及现实场景。这里扩大的是训练素材供给,不是已经验证的工厂产能。它把已有示范改造用于新的任务初始状态、物体或机器人,让人工采集不必承担每一次重复。研究中的特定任务结果,不能直接换算为一家工厂的节拍提升。MimicGen研究项目
这条路线也没有把真实数据排除出去。NVIDIA在2026年1月的技术文章中介绍,GR00T N1.6使用仿真和真实机器人数据。该文还介绍了一套结合全身控制、合成数据训练导航与视觉定位的流程,并指出面向具体机器人或任务部署时,微调有益。这是厂商公布的技术流程,并非跨工厂独立验证的经营收益。NVIDIA技术说明
企业因此值得关注一种新的生产资料:经过现场检验、还能反复补充的任务数据包。它至少应包含操作示范、允许变化的工况、失败样本和验收记录。只购买模型权重或一批生成视频,通常不足以回答下次换料、换灯光之后还能不能用。这是本文基于上述流程提出的管理判断。
把数据产量改成可检验的账
合成场景是否覆盖真实故障,是试点要验证的问题。以取放工件为例,团队可以检查训练集是否只出现居中摆放的零件,却漏掉遮挡、反光与料箱边缘。更大的数据集也可能只是在重复同一种容易情况。MimicGen公开文档就指出,一类使用更长插值片段的数据仍对模仿学习构成明显挑战;不同仿真器版本的视觉和动力学差异,还可能使复现成绩变化。MimicGen数据文档
据此,负责人可以把数据预算与三个问题绑定:补了哪个失败条件,是否改善未见过的现场样本,新增维护工作是否值得。验收记录应保存模型、数据和仿真环境的版本,不把一次通过当作长期能力证明。
企业现在可以做的试验
先选一个低风险、可隔离、边界清楚的工位,例如非危险零件取放,不从多人混行或高力接触任务起步。由工艺人员列出允许变化范围,留出一组不参与训练的真实测试条件,并事先写明停机、人工接管及恢复要求。
接着在相同设备和测试条件下,比较两组方案:一组只使用已有真实示范,另一组增加合成数据;把额外训练算力与调试工时同时记账。测试分别记录任务成功、人工接管、单次耗时、工件损伤与恢复时间,不能只挑顺利片段。先在隔离环境完成验证,再由现场安全责任人决定是否进入有限生产测试。
试验应有清楚的退出条件:若改善只出现在仿真中,或接管与维护负担抵消了收益,就暂停扩量,返回失败样本分析。反过来,只有在预先保留的真实条件下也有稳定改善,才考虑扩大物体、场景或班次范围。这里没有通用的提升比例,阈值应由本厂现有流程和风险承受能力确定。
下一步可能怎样变化
如果这种闭环逐渐成熟,工艺工程师的工作可能增加一项:把现场例外转为可复用的训练条件。供应商之间的差异,也可能越来越体现在能否说明数据覆盖了什么、遗漏了什么,以及换线后怎样重新验证。这是未来推演,尚不能当作行业普遍现实。对企业家而言,今天更可靠的起点,是让一小包训练数据通过真实工位验收,再讨论大规模复制。